縦書き OCR 無料・縦書き日本語を正確にテキスト化
登録不要・インストール不要・1日3回まで無料。
手書き・縦書き・PDF(全ページ・検索可能 PDF 出力)対応。日本語に最適化された高精度OCR。
画像・PDFをドラッグ&ドロップ
または
手書き対応
手書き文字も高精度認識
縦書き対応
縦排テキストもそのまま読取
プライバシー安心
処理後すぐに画像を削除
縦書き OCR とは — 日本語特有の縦組みを読み取る技術
縦書き OCRは、日本語の縦書き(縦組み)テキストを画像から読み取り、編集可能なデジタルテキストへ変換する技術です。日本語には縦書きと横書きの 2 つの表記方向があり、新聞・小説・古文書・公文書など多くの日本語文書は縦書きで書かれてきました。しかし大半の OCR ソフトは英語を前提に設計されているため、縦書き日本語は読み取れないか、認識精度が大きく落ちます。
AI OCR(ocrjp.com)は縦書きテキストを自動検出し、右から左への正しい読み取り順序でテキスト化します。古文書、小説、新聞、手紙、和歌など、縦書きで書かれたあらゆる文書に対応。登録不要・ブラウザだけで利用できます。
実際の読み取り例(1943 年刊・活字の縦書きページ)
国立国会図書館・Internet Archive で公開されているパブリックドメインの小説(土家由岐雄『昭南島』1943 年、旧字・旧かな)の 1 ページを、そのまま当サイトで認識した結果です。画像の加工はしていません。
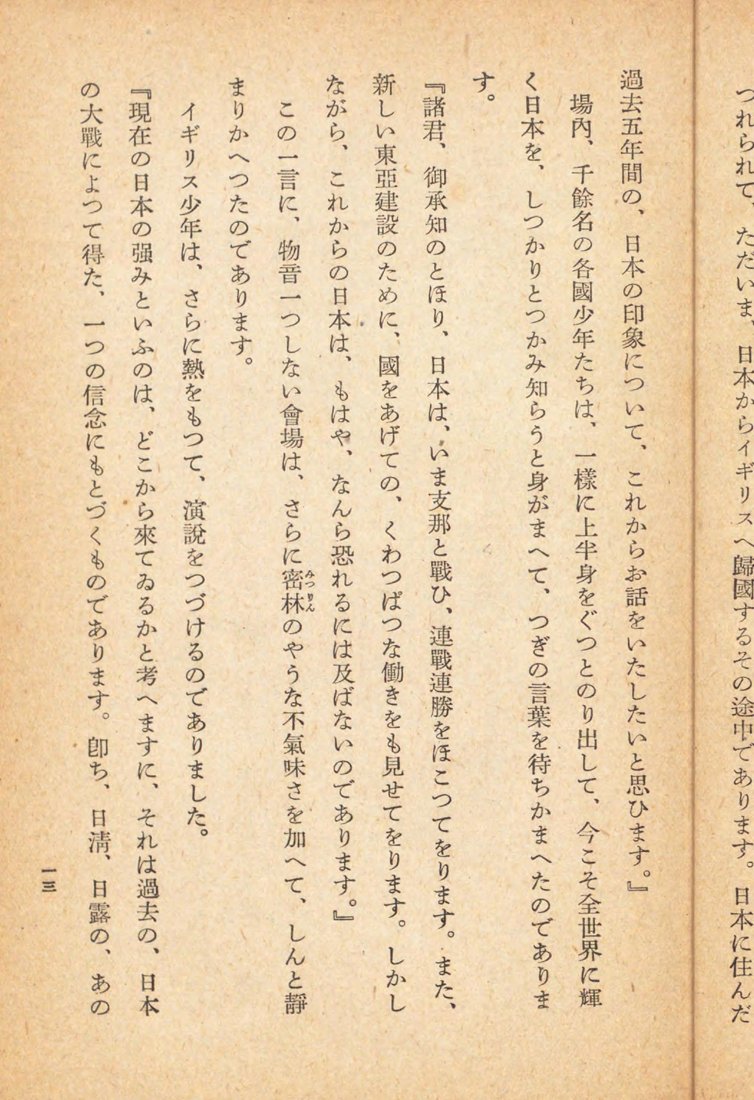
つれられて、ただいま、日本からイギリスへ歸國するその途中であります。日本に住んだ
過去五年間の、日本の印象について、これからお話をいたしたいと思ひます。』
場内、千餘名の各國少年たちは、一樣に上半身をぐつとのり出して、今こそ全世界に輝
く日本を、しつかりとつかみ知らうと身がまへて、つぎの言葉を待ちかまへたのでありま
す。
『諸君、御承知のとほり、日本は、いま支那と戰ひ、連戰連勝をほこつてをります。また、
(以下略・全 13 列)
- うまくいく条件:活字、1 ページに十分な列数、傾きが小さいスキャン。ルビは本文から除外されます。
- 崩れやすいところ:ページ端で切れた列(この例でも最後の列は端が欠けて 1 字誤読)、傍点・圏点が付いた語(記号が文字として混ざる)、見開きを 1 枚で撮った写真(左右ページの列が交互になる)。見開きは左右を分けてアップロードしてください。
- この例の認識結果は「検索可能 PDF」「Word」でもそのまま保存できます。
- 崩れたときの直し方は 縦書き OCR でルビや読み順が崩れるときの対処法 にまとめています。
こんな縦書き文書を読み取れます
- 古文書・歴史資料 → デジタルアーカイブ化
- 縦書きの小説・書籍 → テキスト化、または検索可能 PDF にして本のまま検索
- 新聞記事(縦組み) → テキストとして保存
- 手書きの手紙(縦書き) → デジタル記録
- 和歌・俳句・短歌 → テキストデータとして活用
- 縦書きの看板・ポスター → 翻訳・テキスト化
- 会社の公文書・社史 → デジタル保管
縦書き PDF を横書きテキストに変換する
「縦書きの PDF を横書きに変換したい」という場合、必要なのはレイアウトの変換ではなく文字の読み取りです。縦書き OCR で読み取った結果は横書きのテキスト(1 列 = 1 行)として出力されるので、そのままコピーして横書きの文書に貼り付けたり、Word で横組みの文書にしたりできます。
- PDF を PDF OCR にアップロードし、ページ一覧から変換したいページを選ぶ(1 ページ = 1 回分)
- 縦書きは自動判定され、右の列から順に横書きテキストとして出力される
- 「全部コピー」または「.docx」で保存。原文のまま検索したい場合は「検索可能 .pdf」(元の縦書きの見た目のまま、文字を検索・コピーできる)
旧字・旧かなは原文どおりに出力されます。ルビは本文から除外されます。崩れたときの直し方は縦書き OCR でルビや読み順が崩れるときの対処法を参照してください。
なぜ縦書き OCR は難しいのか — 6 つの技術課題
一般的な OCR エンジンは横書き(特に英語)を前提に設計されています。縦書き日本語を正しく読み取るには、以下の課題を同時に解決する必要があります。
- 文字列の方向検出 — 縦に並んだ文字列を 1 つのブロックとして認識する。アルゴリズムが「横並びの文字列」だけ探していると縦書きを見落とす。
- 読み取り順序 — 縦書きは右の列から左の列へ、各列は上から下へ読む。これは英語圏の OCR ライブラリのデフォルトとは真逆。
- 混在レイアウト — 縦書きと横書きが混在する文書(学術書、雑誌など)で、各ブロックを正しく分離する。
- ルビ(ふりがな)の分離 — 本文の右側に小さく付くルビを本文テキストと混同しない処理。
- 縦中横(たてちゅうよこ) — 縦書きの中に半角数字や英字が横向きで埋め込まれる組版。OCR では特殊扱いが必要。
- くずし字・古典文字 — 古文書では現代の活字とは形が異なる文字が多用される。深層学習モデルでは推論精度が落ちる。
AI OCR はこれらすべての課題に対応した縦書き専用の処理パイプラインを実装しています。OCR 精度ベンチマークでは、縦書きテキストで GPT-4o が CER 0.000(完全一致)、PaddleOCR が CER 0.008 という実測値を記録しています。
縦書き OCR ソフトの選び方 — 用途別おすすめ比較
市場には複数の縦書き OCR ソフト・サービスがあります。用途別に最適なツールを選ぶための比較表を示します。
| ツール | 縦書き対応 | くずし字 | 登録 | 料金 | 備考 |
|---|---|---|---|---|---|
| AI OCR(ocrjp.com) | ◎ 自動検出 | ◯(自動) | 不要 | 無料(1 日 3 回) | ブラウザだけで完結 |
| Google Drive OCR | △ 一部 | × | 必要 | 無料 | 横書き優先で誤認識多発 |
| Adobe Acrobat OCR | △ 一部 | × | 必要 | 有料 | 印刷物向け、縦書き手書きは弱い |
| Tesseract(ローカル) | △ 設定要 | × | 不要(要インストール) | 無料 | vert モデル別途、設定が複雑 |
| bunkoOCR(iOS アプリ) | ◯ | ◯ | 必要 | 有料 | iPhone 専用 |
ブラウザだけで縦書き OCR を試したい方は、AI OCR(ocrjp.com)が最も手軽です。アプリインストール・登録・支払い情報のいずれも不要で、画像を 1 枚アップするだけで縦書き日本語をテキスト化できます。
他の OCR ツールとの精度差 — 実測データ
Google Drive や Adobe Acrobat などの OCR ツールは、縦書き日本語の認識精度が低いことが知られています。特に古文書や手書きの縦書きテキストでは、誤認識が多発します。
AI OCR は縦書き日本語に特化した認識モデルを搭載しており、縦書きテキストの方向を自動検出して最適な認識処理を行います。さらに手書きなどの難しいページでは「高精度で再認識する」(1回分)で最新の AI モデルが文脈推論で読み取るため、印刷物だけでなく手書きの縦書きや古文書にも実用精度で対応します。
📜 手書きの縦書き文書は AI が自動で認識
手書きの手紙、古文書、走り書きの縦書きを読み取りたい場合は、AI 手書き OCRのページもご参照ください。AI(Gemini)が文脈推論で手書きをテキスト化します。縦書きのスキャン PDF は PDF OCR でそのままテキスト化できます。横書き画像のテキスト化はトップページからどうぞ。
よくある質問
Q. 縦書きと横書きが混在する文書も読み取れますか?
はい、AI OCRは文書内の縦書き・横書きを自動的に判別し、それぞれ適切な方向で認識します。
Q. 古文書(くずし字)も読み取れますか?
一般的な縦書き印刷物や手書きの縦書きは高精度に認識できます。極端なくずし字や特殊な書体は「高精度で再認識する」(1回分)をお試しください。
Q. 読み取り順序は正しく処理されますか?
はい、縦書きテキストは右列から左列、各列は上から下の正しい順序でテキスト化されます。
Q. ルビ(ふりがな)も認識できますか?
ルビは本文とは別のテキストブロックとして認識される場合があります。認識結果から手動で整理していただく必要がある場合があります。
Q. 縦書き OCR ソフトは何を選べばいいですか?
用途次第です。印刷された縦書き文書ならローカル動作の PaddleOCR(実測 CER 0.008)も高精度ですが、設定が複雑。手書きの縦書きや古文書を読みたい場合は、AI モデル搭載のサービス(AI OCR、bunkoOCR など)が必要です。ブラウザで完結したい・登録したくない方は、AI OCR(ocrjp.com)が最も手軽な選択肢です。
Q. 縦中横(半角数字を含む縦書き)は読み取れますか?
はい、縦書きの中に半角数字や英字を横向きで埋め込む「縦中横(たてちゅうよこ)」も認識します。AI による高精度認識が使われる場合は、組版の文脈を考慮してより正確にテキスト化できます。
Q. 古文書(江戸期以前の和本)も読み取れますか?
活字で印刷された明治以降の縦書きは高精度に認識できます。江戸期以前の手書き和本(くずし字・変体仮名)は AI による高精度認識で対応しますが、極端なくずし字や難読部分は人間による校正をおすすめします。専門的な古文書翻刻には NDL(国立国会図書館)の「みを」プロジェクトもあわせてご検討ください。
Q. 縦書きの PDF を横書きに変換できますか?
できます。縦書き OCR の結果は横書きのテキスト(1 列 = 1 行)として出力されるので、コピーして横書きの文書に貼り付けるか、Word(.docx)で保存すれば横組みになります。複数ページの PDF は PDF OCR でページを選んで変換できます(1 ページ = 1 回分)。元の縦書きの見た目のまま検索できる PDF にしたい場合は「検索可能 PDF」で保存します。