縦書きの小説やスキャンした公文書を OCR にかけると、「文字は合っているのに文章にならない」ことがあります。列の順番が入れ替わる、ふりがなが本文に紛れ込む、文字の間に記号が湧く——原因はほぼ 5 つに絞れます。この記事では当サイト(縦書き OCR)で実際に起きた例を使って、症状ごとに原因と直し方をまとめます。
先に結論:症状と対処の早見表
| 症状 | 主な原因 | 直し方 |
|---|---|---|
| 列の順番が入れ替わる・左右ページが混ざる | 横書き前提のエンジン/見開きを 1 枚で撮影 | 縦書き専用エンジンを使う。見開きは左右を分ける |
| ルビ(ふりがな)が本文に混ざる | 小さな文字も本文として拾う | 「通常」タブ(縦書き専用エンジン)の結果を使う |
| 文字の間に「-」や「、」が入る | 傍点・圏点を文字として認識 | 出力後に置換で消す |
| ページ端の列だけ誤読・欠落 | 端の列が数ミリ欠けている | 余白を含めて撮り直す |
| 横書きとして読まれる | 列数が少ない/横書き混在/傾き | 本文だけを 1 ページ丸ごと撮る。駄目なら高精度で再認識 |
症状 1:列の順番が入れ替わる・左右ページが混ざる
縦書きは右の列から左へ読みます。横書き前提の OCR は「上の行から下へ」並べるので、列の順番が崩れたり、1 列の途中で隣の列に飛んだりします。見開きを 1 枚の写真に収めると、右ページと左ページの列が交互に出てくるのもこのためです。
当サイトの縦書きは国立国会図書館が公開している縦書き専用エンジン(NDLOCR-Lite)で読んでいるため、右から左の順で 1 列 = 1 行として出力されます。下は 1943 年刊の小説ページをそのまま認識した例で、13 列が右から順に並んでいます(縦書き OCR のページに全文があります)。
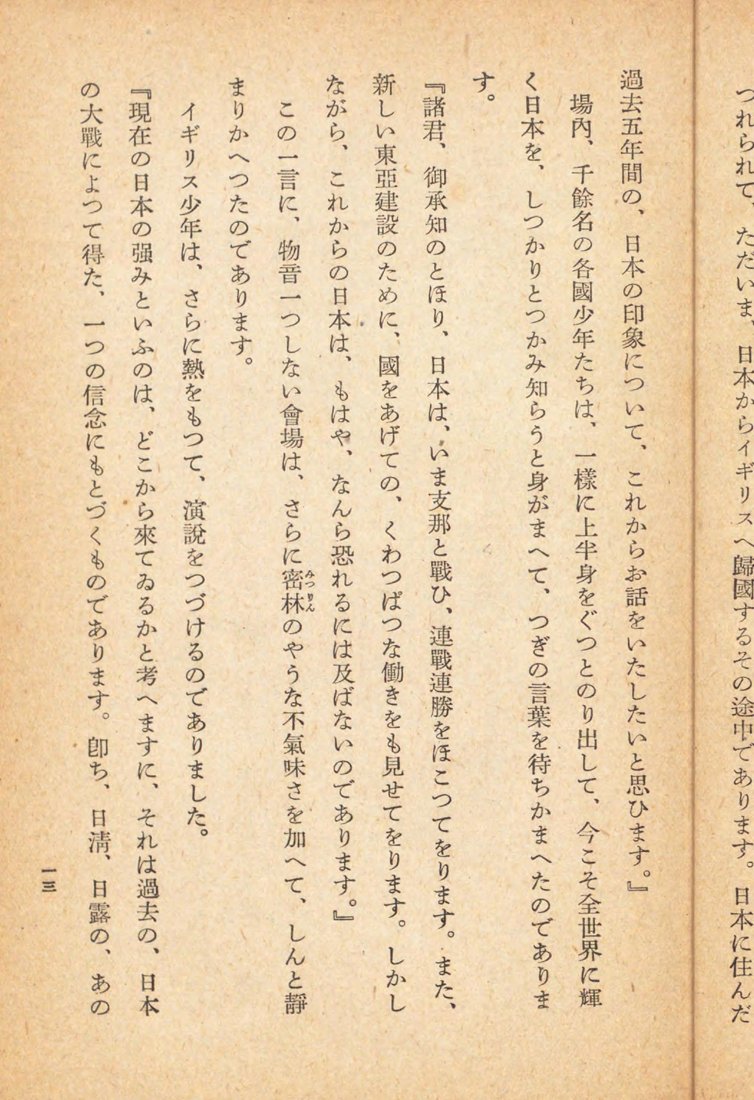
直し方:見開きは左右のページを別々に撮るか、PDF OCR でページごとに分けてから認識してください。1 枚にまとめたい場合は、右ページ→左ページの順で結果を貼り合わせます。
症状 2:ルビ(ふりがな)が本文に混ざる
ルビは本文の右側に小さく組まれています。文字の大きさを区別しないエンジンは、これも本文として拾い、「みち道で会あったとき」のような二重読みになります。手書きの例ですが、当サイトのベンチマークで Google Cloud Vision がルビ付きの手紙を読んだときは、本文の前にルビの読みがそのまま出力されました(比較記事参照)。
直し方:縦書き専用エンジンの出力(当サイトでは「通常」タブ)はルビを除外します。AI による「高精度で再認識する」は文脈で読み分けますが、ルビの多い児童書などでは混ざることがあるので、そのときは「通常」タブの結果を使ってください。両方の結果はタブで切り替えて見比べられます。
症状 3:文字の間に「-」や「、」が入る(傍点・圏点)
古い印刷物では強調したい語の横に点(傍点・圏点)を打ちます。エンジンはこれを小さな文字として拾い、「い-た-ち」「御-め-え」のように文字の間に記号を挟んで出力します。文字自体は正しく読めているので、これは誤読ではなく原文の記号が残った状態です。
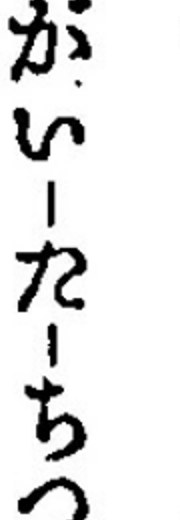
直し方:出力をテキストエディタに貼り、「-」を空文字に置換すれば元に戻ります(ハイフンを含む英数字や電話番号が同じページにないか確認してください)。強調箇所の目印として残す使い方もできます。
症状 4:ページ端の列だけ誤読・欠落する
スキャンや撮影で端の列が数ミリ欠けると、その列の文字が半分しか写らず、1〜2 文字が別の字に化けます。上の 1943 年の例でも、左端の列が綴じ目側で欠けており、「臭えの臭く」が「奧えの臭く」と読まれました。エンジンの問題ではなく、入力画像に文字が写っていないケースです。
直し方:余白を含めて少し広めに撮る、スキャナーの読み取り枠を広げる、本を開くときに綴じ目側を押さえる。認識結果の「位置を表示」を使うと、どの列がページ端にかかっているかが画像上で確認できます。
症状 5:縦書きなのに横書きとして読まれる
当サイトは画像ごとに縦書きか横書きかを自動判定しますが、判定材料が足りないと横書きとして処理されます。典型は次の 3 つです。
- 列数が少ない:看板・名刺・数行だけの切り抜き。判定に必要な列が足りません。
- 横書きが混ざっている:横書きの見出し、図表、ページ番号、欄外の英数字。
- 傾きが大きい:斜めから撮った写真。
直し方:本文の縦書き部分だけが写るように、できるだけ 1 ページ丸ごと正面から撮ってください。横書き部分はトリミングで落とします。それでも横書きとして出る場合は「高精度で再認識する」(1 回分)で AI に読ませると、短い縦書きでも読み順が整うことが多いです。
補足:旧字・旧かなはそのまま出る
戦前の印刷物では「歸・餘・戰」などの旧字と「思ひます」「ゐる」などの旧かなが、原文どおりに出力されます。これは正しい動作です。現代表記に直したい場合は別途変換が必要ですが、原文のまま検索可能 PDF にしておけば、旧字で検索できる資料として保存できます。
チェックリスト
- 見開きは左右に分けた
- 余白を含めて 1 ページ丸ごと、正面から撮った
- 横書きの見出し・図表は切り落とした
- ルビが混ざったら「通常」タブ、崩し字や短い縦書きは「高精度で再認識する」
- 傍点の「-」は置換で消す
- 端の列の誤りは「位置を表示」で画像と照合して直す
縦書きの本を 1 冊まとめて読む場合は、PDF OCR でページを選んで認識し、Word または検索可能 PDF で保存できます。
関連記事
👉 縦書き OCR 無料 — 実際の読み取り例と使い方。
👉 OCR 精度ベンチマーク — 縦書きシナリオでの各エンジンの CER。
👉 OCR の精度が悪い 5 つの原因と対処法 — 撮影・画像側の対処。
よくある質問
Q. 縦書き OCR で列の順番がばらばらになるのはなぜですか?
横書き前提の OCR は行を上から下へ並べるため、縦書きの列を左右に関係なく拾ってしまいます。見開きを 1 枚で撮ると左右ページの列が交互に混ざります。縦書き専用エンジン(当サイトでは NDLOCR-Lite)は右の列から順に読み、見開きは左右を分けてアップロードすれば解決します。
Q. ルビ(ふりがな)が本文に混ざるのを防ぐには?
縦書き専用エンジンの出力ではルビは本文から除外されます。AI による高精度認識では小さな文字も読んで本文に混ぜることがあるため、ルビの多い印刷物では「通常」タブの結果を使うのが確実です。
Q. 傍点や圏点が「-」や記号になるのはどうすればいいですか?
傍点(文字の横の点)はエンジンが文字として拾い、文字の間に「-」や「、」が入ることがあります。意味は変わらないので、出力後に置換で消すのが早い対処です。原文で強調されていた箇所の目印として残す使い方もできます。
Q. ページの端の列だけ誤読されるのはなぜですか?
スキャンや撮影で端の列が数ミリ欠けると、その列の文字が半分しか写らず誤読になります。余白を含めて撮る、スキャナーの読み取り枠を広げる、見開きの綴じ目側を押さえて撮る、で防げます。
Q. 縦書きなのに横書きとして読まれてしまいます。
1 ページに十分な列数がない(短い看板・名刺・数行だけの切り抜き)、横書きの見出しや図表が混ざっている、傾きが大きい、のいずれかです。本文の縦書き部分だけを写す、できるだけ 1 ページ丸ごと撮る、傾きを直す、それでも駄目なら「高精度で再認識する」で AI に読ませてください。